30.000 Datensätze, ein Klick: So entsteht der KI-gestützte Katalog in GOAT
Jedes Planungsprojekt beginnt mit der Suche nach Daten. So haben wir einen Katalog mit über 30.000 Datensätzen gebaut, die mit einem Klick in Ihrem GOAT-Projekt landen, und warum eine KI-Suche das nicht ersetzen kann.
Am Anfang jedes Projekts steht die Suche nach Daten. Jede Stadt, jede Region, jedes Land hat ein eigenes Portal aufgebaut. Alles zugänglich, aber alles verstreut. Mit KI scheint das heute einfacher. Sie fragen eine KI nach Bushaltestellen in Bayern und bekommen einen Link zu einem Portal. Vielleicht zum richtigen, vielleicht zu einem, das es nicht mehr gibt. Dann beginnt die eigentliche Arbeit: nachsehen, was da ist, die Metadaten lesen, die Lizenz prüfen, herunterladen, entpacken, die Projektion prüfen, den Grenzlayer suchen, wieder die KI fragen, ein anderes Portal öffnen, klären, ob das der richtige Datensatz ist, herunterladen, zum Projekt hinzufügen. Und jetzt können Sie anfangen zu arbeiten. Entschuldigung für die lange Liste. Es sollte anstrengend klingen. Denn selbst mit KI ist es immer noch mühsam, Daten in ein QGIS- oder GOAT-Projekt zu bringen.
Deshalb haben wir unseren Katalog neu gebaut. Früher enthielt er etwa 60 bis 70 Datensätze, die wir von Hand gepflegt haben. Heute sind es über 30.000. Und die ganze Arbeit von oben ist schon erledigt: Jeder Datensatz ist umgewandelt, geprüft und kommt mit Metadaten und Lizenz. Ein Klick, und er ist in Ihrem Projekt, ohne Download und ohne Import.
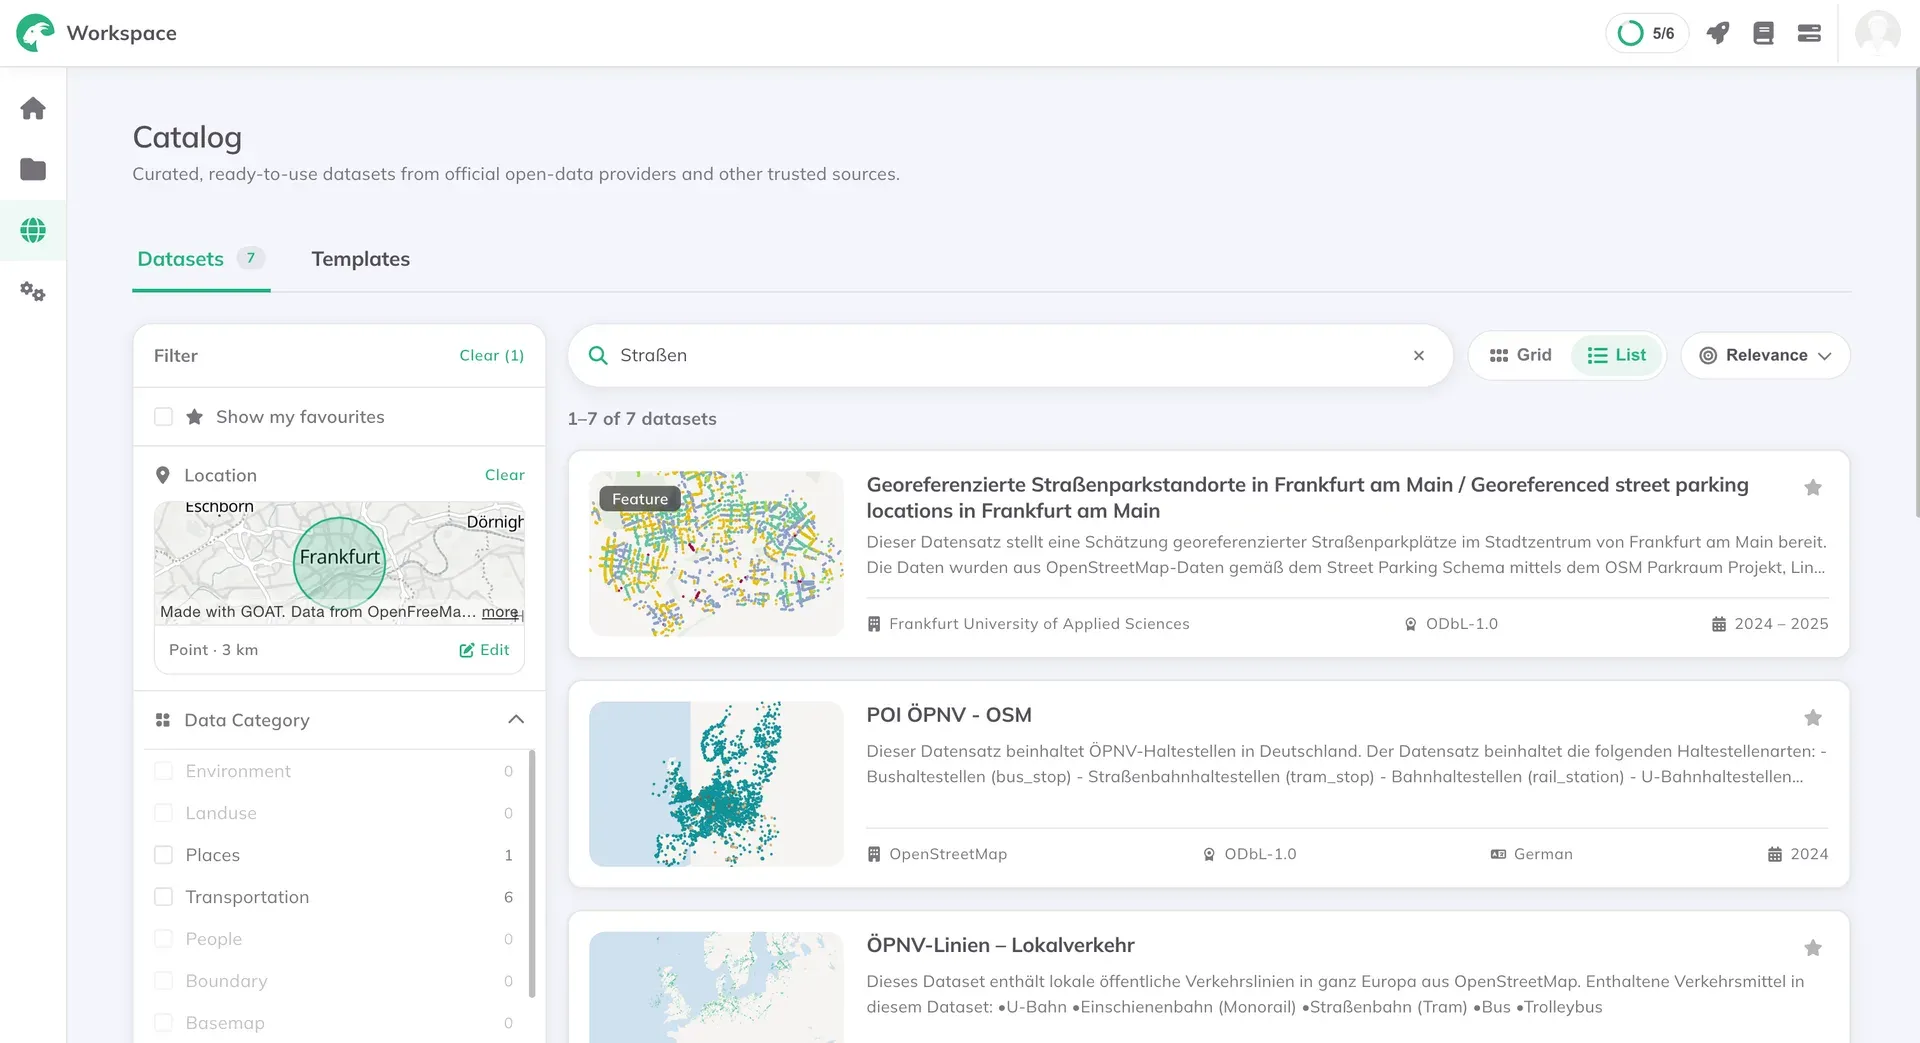
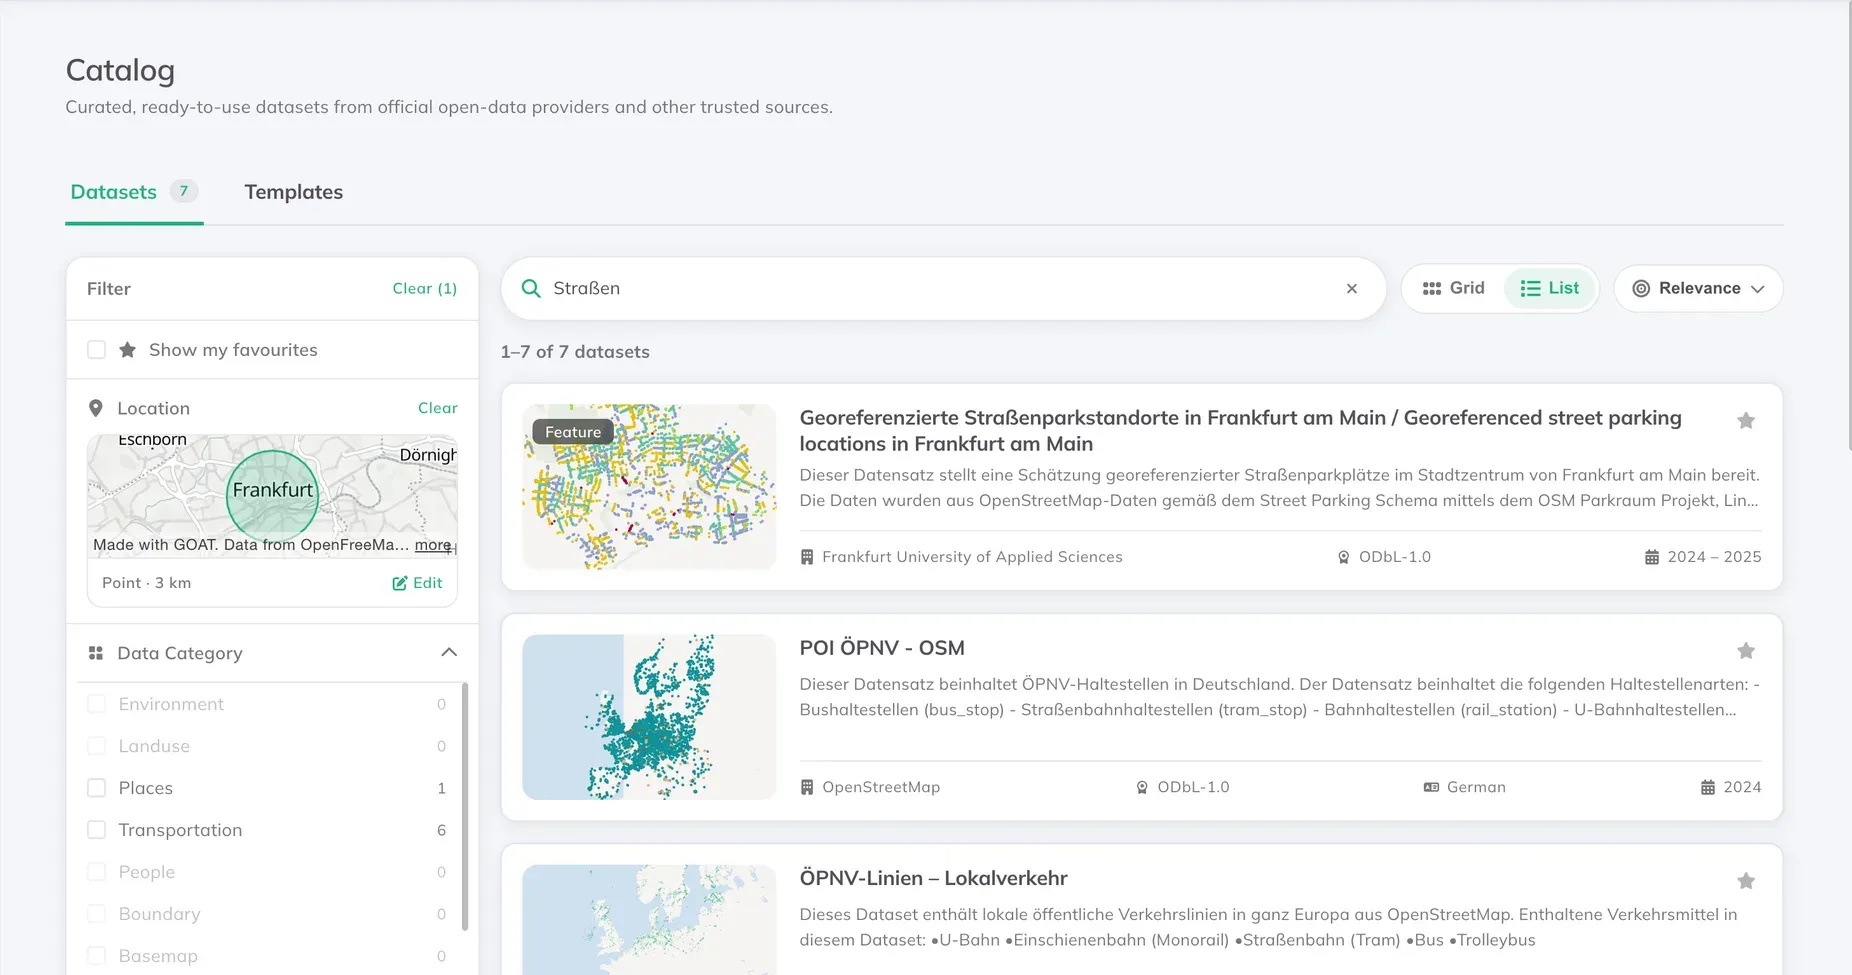
Der Katalog in GOAT: eine Suche statt fünf Portale.
Was der Katalog enthält: die Daten, die Sie brauchen, für Sie kuratiert
Im Katalog kommen zwei Arten von Daten zusammen: offene Daten, die wir aus öffentlichen Portalen einsammeln, und Datensätze, die Plan4Better selbst aufbereitet.
Verwaltungen veröffentlichen große Mengen an Geodaten in Open-Data-Portalen. Sie zu nutzen heißt normalerweise: wissen, in welchem Portal man suchen muss, die Metadaten lesen, eine Datei herunterladen und sie umwandeln, bevor irgendeine Analyse beginnen kann. GOAT sammelt diese Portale ein, damit die Daten sofort nutzbar sind. Sie stammen unter anderem aus:
- GovData: das nationale Open-Data-Portal Deutschlands, in dem Bund, Länder und Kommunen ihre Daten veröffentlichen.
- data.gv.at: das Open-Government-Data-Portal Österreichs.
- geocat.ch: der Geodatenkatalog der Schweiz, betrieben vom Bundesamt für Landestopografie (swisstopo).
- data.europa.eu: das offizielle Portal für europäische Daten, betrieben von der EU. Der Katalog deckt einen Teil davon ab.
Wie wählen wir die Portale aus? Von Hand. Genau das macht die Daten im Katalog vertrauenswürdig. Wir sammeln nicht das ganze Internet ein, wie es eine allgemeine KI-Suche tut. Wir beginnen bei amtlichen Open-Data-Portalen, die wir kennen und denen wir vertrauen, und entscheiden mit unserer Erfahrung aus vielen Jahren Planungsarbeit, welche sich lohnen.
Gute Portale auszuwählen ist aber nur der erste Schritt. Auch amtliche Portale veröffentlichen viel mehr, als die Planung braucht: Haushaltstabellen, Rechtstexte, historische Karten. Wir fragen deshalb nicht: Welche Daten gibt es? Wir fragen: Welche Daten beantworten eine Planungsfrage? Jeder Datensatz wird an dieser Frage gemessen, und nur, was besteht, kommt in den Katalog. Ein Flächennutzungsplan für eine ganze Gemeinde bleibt. Ein Bebauungsplan für ein einzelnes Grundstück, eine historische Karte oder Live-Parkdaten nicht.
Von rund 554.000 gesammelten Datenpaketen haben über 70 % schon die erste Prüfung nicht bestanden. Wie viel aussortiert wird, hängt stark vom Portal ab. In einem Katalog, der speziell für Geodaten gemacht ist, sind die meisten Einträge planungsrelevant. In einem allgemeinen Open-Data-Portal, das alles veröffentlicht, was eine Verwaltung erstellt, ist es dagegen nur ein sehr kleiner Teil.
Außerdem entfernen wir Dubletten. Manche Quellen veröffentlichen dieselben Daten einmal pro Landkreis und noch einmal für den ganzen Regierungsbezirk. Enthält der Layer für den Bezirk alles aus den Layern der Landkreise, behalten wir ihn und lassen die anderen weg. Auch Layer mit identischem Inhalt finden wir und behalten nur einen. Das spart Ihnen Zeit. Stellen Sie sich vor, Sie suchen ein Straßennetz für Bayern und bekommen fünfzig Versionen davon. Sie wären länger mit Auswählen beschäftigt als mit Analysieren. Im Katalog ist diese Auswahl schon getroffen.
Datensätze, die wir selbst aufbereiten
Nicht alles, was die Planung braucht, liegt in nutzbarer Form in einem öffentlichen Portal. Deshalb enthält der Katalog auch Datensätze, die wir selbst erstellen und pflegen. Points of Interest kommen aus OpenStreetMap. Die Rohdaten sind detailliert, aber unordentlich, also korrigiert unsere Verarbeitung sie und fasst sie in Kategorien zusammen, die für die Planung Sinn ergeben, etwa Dienstleistungen oder Tourismus und Freizeit. Haltestellen, Bahnhöfe und Linien des öffentlichen Verkehrs stammen aus den GTFS-Fahrplandaten der Verkehrsunternehmen und decken Nah-, Regional- und Fernverkehr ab.
Wir haben den Katalog gebaut, den wir selbst nutzen wollten. Wir sind ebenfalls Planerinnen und Planer und arbeiten jeden Tag mit Kommunen und Planungsbüros. Deshalb wissen wir: Entscheidend sind nicht Millionen von Datensätzen. Entscheidend sind Datensätze, denen Sie vertrauen können und die das ganze Gebiet abdecken, an dem Sie arbeiten.
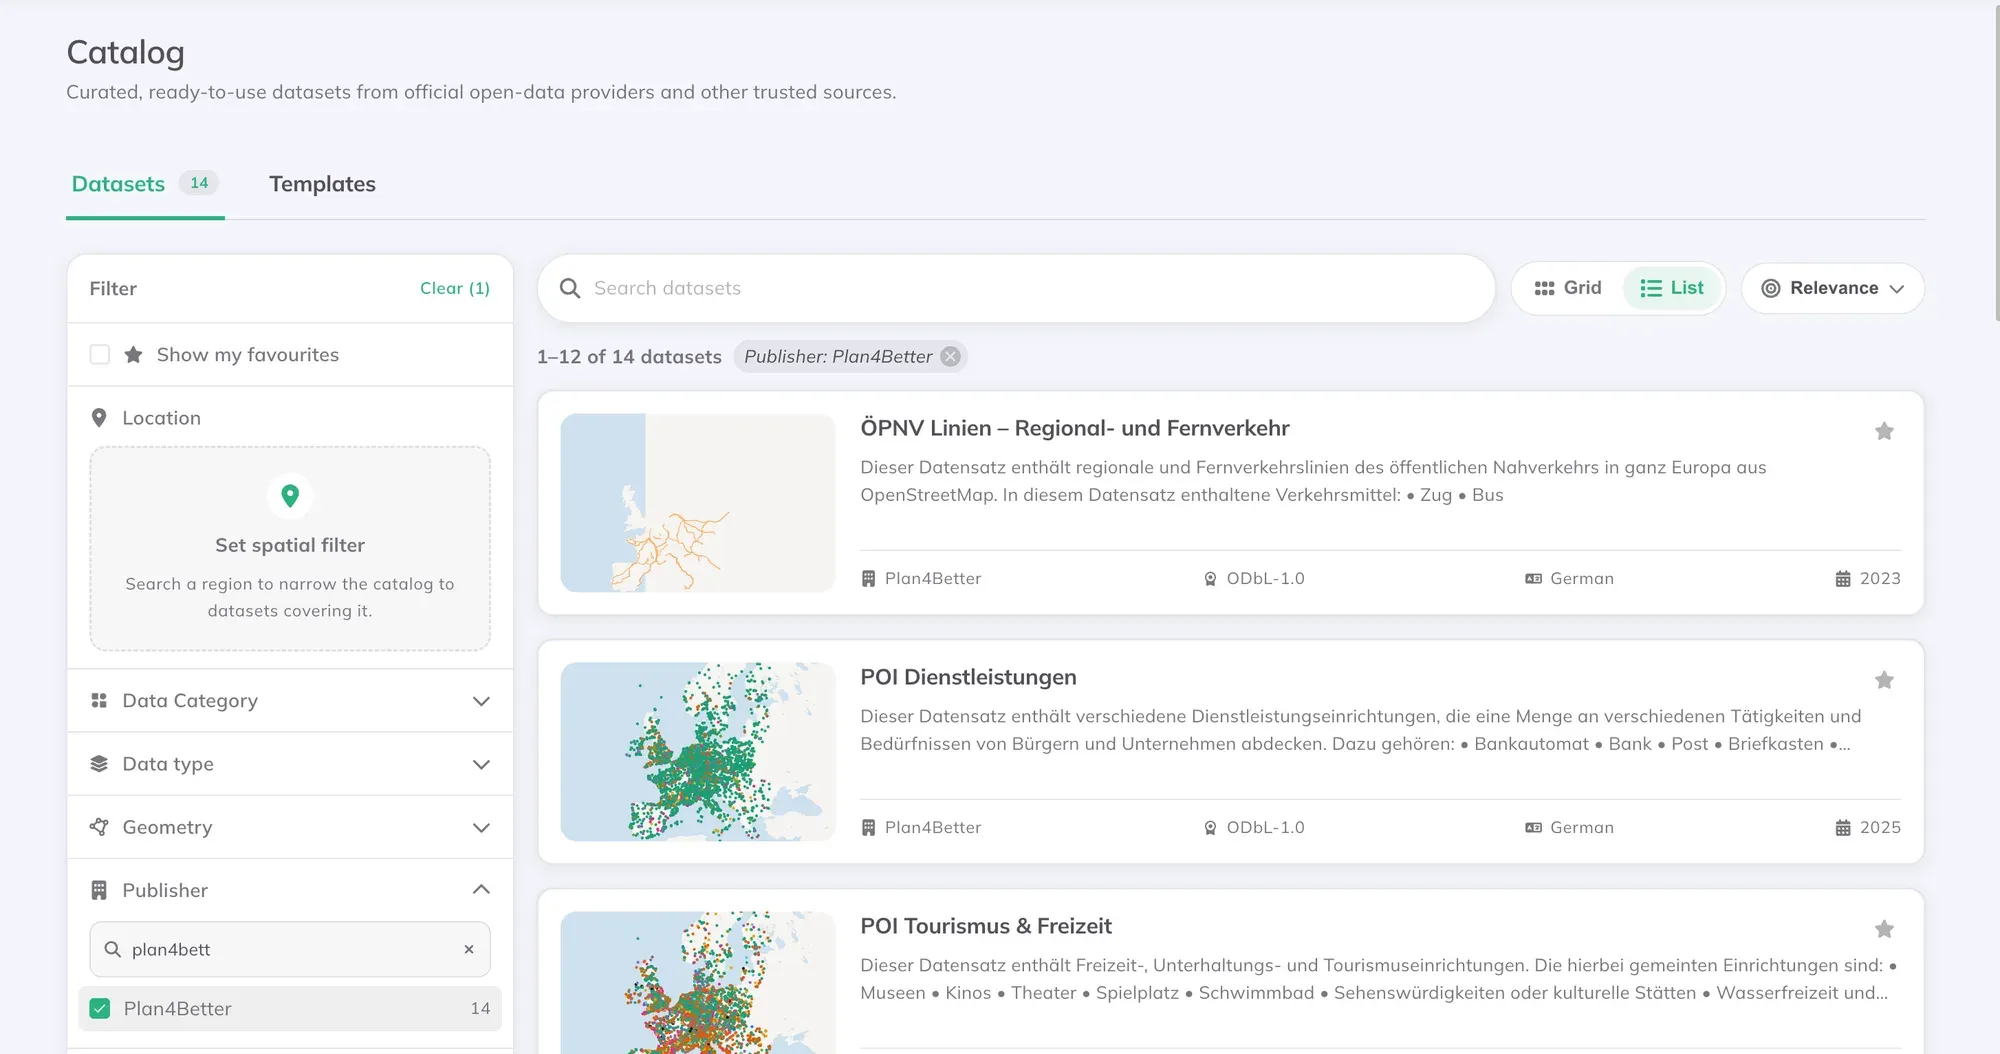
Die Datensätze, die Plan4Better aufbereitet, gefiltert nach Herausgeber.
So nutzen Sie den Katalog: Sie filtern, was Sie brauchen
Über 30.000 Datensätze sind immer noch viel, deshalb ist der Katalog darauf ausgelegt, die Auswahl schnell einzugrenzen. Sie öffnen ihn im Workspace oder direkt über Layer hinzufügen, während Sie in einem Projekt arbeiten.
Weiter eingrenzen können Sie, indem Sie eingeben, was Sie suchen, etwa „Lärmkarte“ oder „Radverkehrsnetz“, und nach Kategorie, Lizenz oder Format filtern. Um woanders zu suchen, geben Sie eine andere Stadt oder Region ein oder zeichnen Ihr eigenes Gebiet auf der Karte.
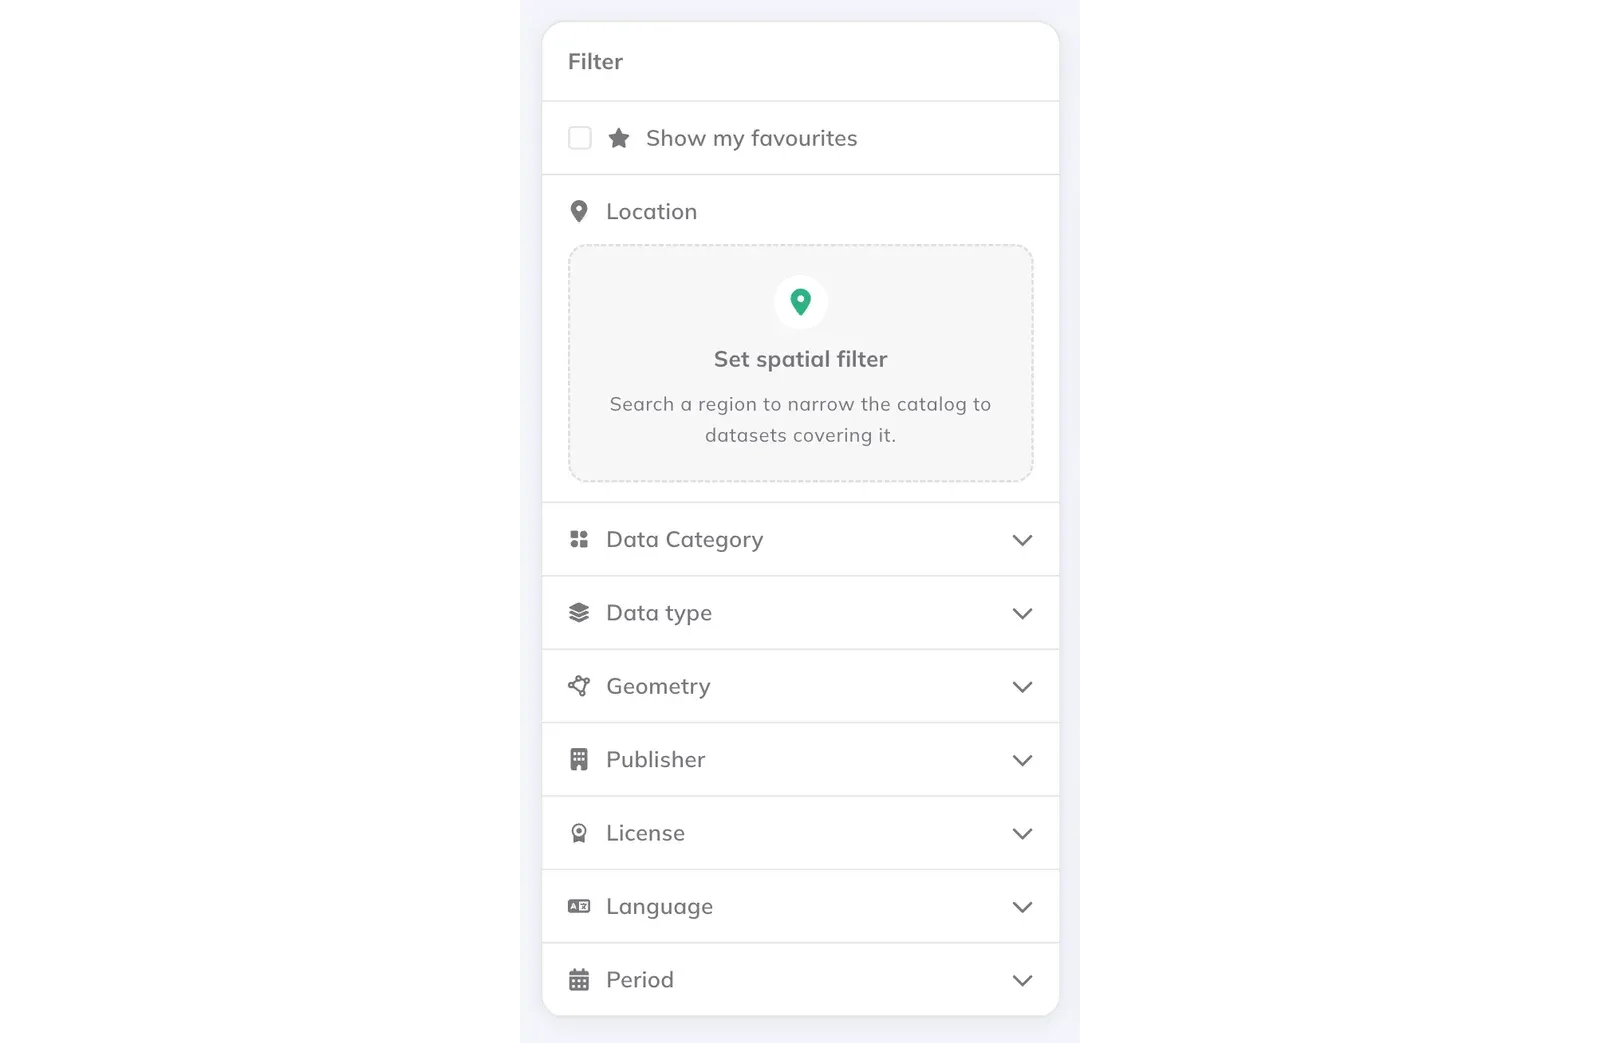
Filter für Standort, Kategorie, Herausgeber, Lizenz und mehr.
Öffnen Sie den Katalog aber aus einem Projekt heraus, weiß er schon, wo Sie arbeiten. Er zeigt zuerst die Datensätze für das Gebiet auf Ihrer Karte, sodass die ersten Ergebnisse die sind, die Ihnen weiterhelfen.
Der Katalog findet die Daten für das Gebiet auf Ihrer Karte.
Manche Datensätze brauchen Sie immer wieder. Sie können sie als Favoriten markieren, dann warten sie beim nächsten Öffnen des Katalogs auf Sie. Haben Sie den richtigen gefunden, fügen Sie ihn mit einem Klick zu Ihrem Projekt hinzu. Nichts herunterladen, nichts importieren. Der Layer ist sofort auf Ihrer Karte, bereit für ein Einzugsgebiet oder jedes andere Werkzeug in GOAT.
Wozu ein Katalog, wenn man eine KI fragen kann?
Eine berechtigte Frage. Eine KI-Suche kann gut auf etwas zeigen. Fragen Sie nach Bushaltestellen in Bayern, und Sie bekommen einen Link. Sie kann aber nicht garantieren, dass der Link funktioniert, dass der Datensatz der richtige ist oder dass es derselbe ist, den Ihre Kollegin letzten Monat verwendet hat. Im Katalog kommt jeder Datensatz mit seinen Metadaten. Sie sehen, woher er stammt, wer ihn veröffentlicht hat und unter welcher Lizenz.
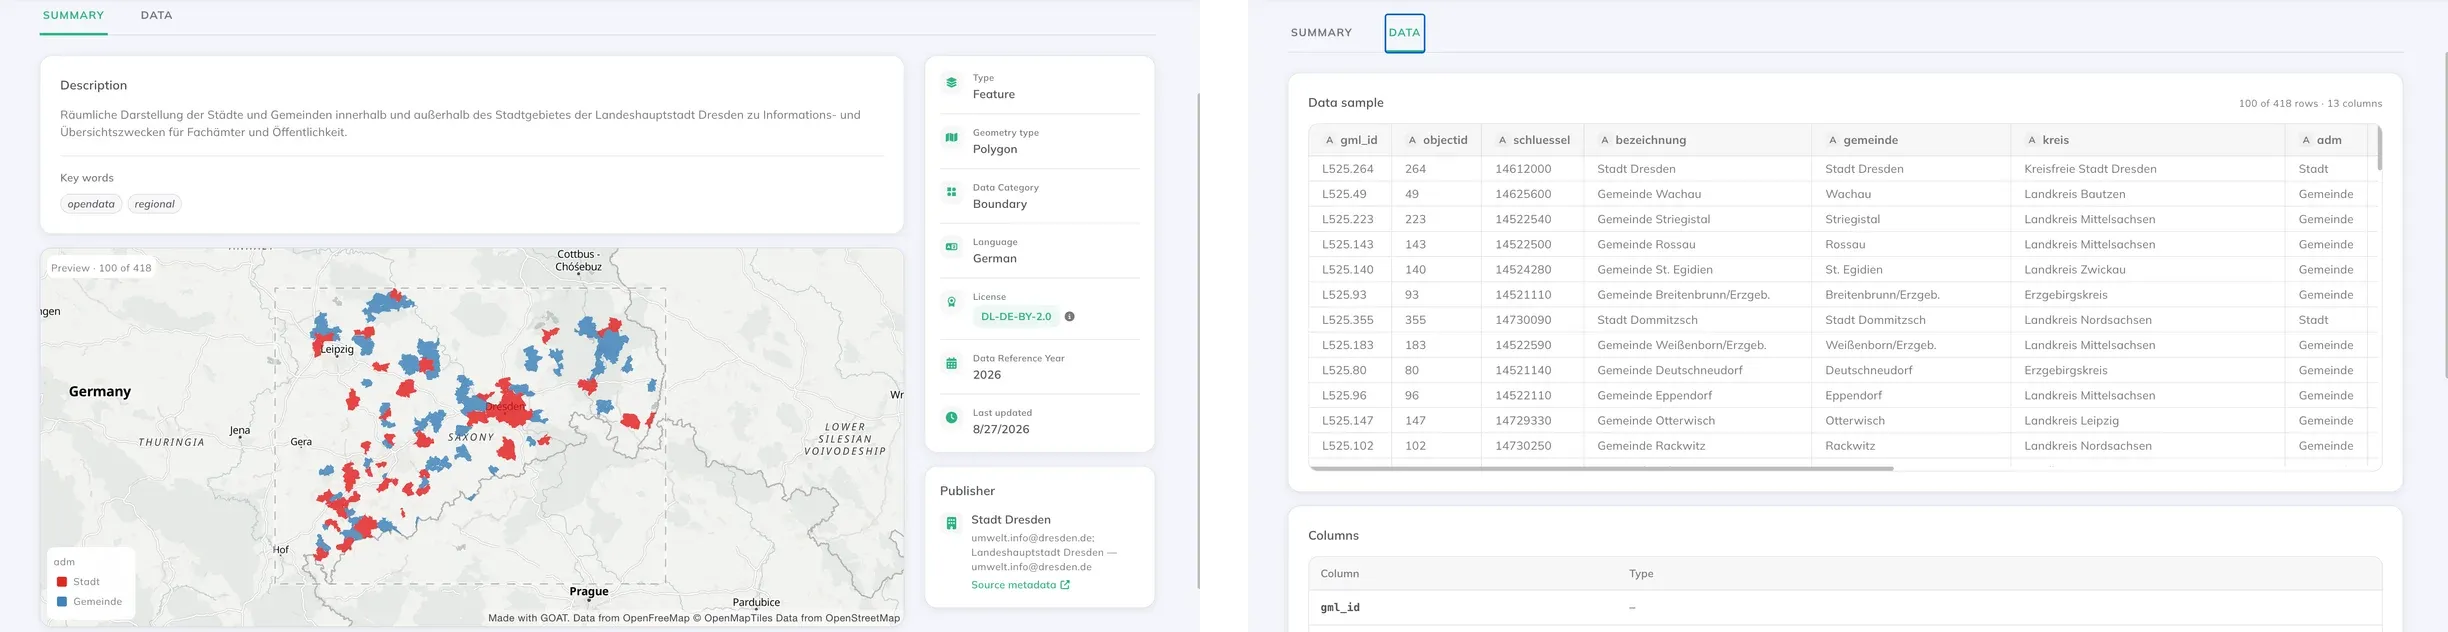
Jeder Datensatz mit seinen Metadaten und einer Stichprobe der Daten, bevor Sie ihn hinzufügen.
Ein Katalog zeigt Ihnen außerdem Daten, nach denen Sie gar nicht gefragt hätten. Eine KI beantwortet die Frage, die Sie eingeben. Ein Katalog, in dem Sie stöbern können, zeigt Ihnen, was es gibt, und manchmal ist der nützlichste Datensatz einer, nach dem Sie gar nicht gesucht haben.
Und ehrlich gesagt nutzen wir auch KI. 554.000 Datensätze von Hand auf ihre Planungsrelevanz zu prüfen, würde Jahre dauern. Deshalb liest ein Sprachmodell Titel, Beschreibung und Schlagwörter jedes Datensatzes und entscheidet. Der Unterschied: Es macht das einmal, für alle, statt dass jede Planerin und jeder Planer für jedes Projekt neu fragt. Perfekt ist es nicht. Bei Stichproben haben wir gesehen, dass es Daten aussortiert hatte, die die Planung durchaus braucht, etwa die amtlichen Bodenrichtwerte in Nordrhein-Westfalen und Daten zu Elektrobussen in Hamburg. Ein fälschlich aussortierter Datensatz ist der schlimmere Fehler, weil ihn niemand je zu sehen bekommt. Deshalb prüfen wir weiter Stichproben und verbessern die Anweisungen, die das Modell bekommt.
Eine KI kann Ihnen sagen, wo die Daten liegen könnten. Der Katalog ist die Daten, bereit zur Nutzung.
Wie es weitergeht: KI, die für Sie sucht, und natürlich mehr Daten
Fertig sind wir noch nicht. Als Nächstes bringen wir KI in die Suche selbst. Statt Filter einzeln zu setzen, beschreiben Sie in eigenen Worten, was Sie brauchen, zum Beispiel „Lärmkarten für Freiburg“ oder „Radverkehrsnetze in der Gemeinde, an der ich arbeite“, und bekommen die passenden Datensätze mit Inhalt, Lizenz und Datum. Außerdem kommt eine Möglichkeit, Daten direkt aus OpenStreetMap und Overture Maps zu holen. Mit KI können Sie dann nach verfügbaren Daten fragen, egal wo auf der Welt Sie arbeiten.
Also: viele Neuerungen, viele Daten, und jetzt liegt es an Ihnen, was Sie daraus machen. Öffnen Sie GOAT und probieren Sie den Katalog kostenlos aus. Projekt öffnen, auf Layer hinzufügen klicken und nach dem ersten Datensatz suchen, den Sie brauchen. GOAT können Sie kostenlos testen. Wenn Sie Inspiration suchen, starten Sie mit einer Vorlage oder sehen Sie sich unsere Projekte in der Kartengalerie an.
Häufige Fragen
Was ist der GOAT-Katalog?
Der GOAT-Katalog ist eine Sammlung von über 30.000 offenen Geodatensätzen in GOAT, dem WebGIS von Plan4Better. Sie können ihn durchsuchen und filtern und jeden Datensatz mit einem Klick zu einem Projekt hinzufügen, ohne etwas herunterzuladen oder zu importieren.
Woher kommen die Daten im GOAT-Katalog?
Der größte Teil stammt aus amtlichen Open-Data-Portalen in Deutschland, Österreich, der Schweiz und der EU, etwa GovData, data.gv.at, geocat.ch und data.europa.eu. Dazu kommen Datensätze, die Plan4Better selbst aufbereitet, zum Beispiel Points of Interest aus OpenStreetMap sowie Haltestellen und Linien des öffentlichen Verkehrs aus GTFS-Fahrplandaten.
Wie entscheidet GOAT, welche Datensätze in den Katalog kommen?
Jeder Datensatz aus den Portalen wird auf seine Relevanz für die Planung geprüft. Einfache Regeln sortieren zuerst veraltete, nur einen einzelnen Standort betreffende und doppelte Einträge aus. Danach liest ein Sprachmodell Titel, Beschreibung und Schlagwörter jedes Datensatzes. Was besteht, wird heruntergeladen, umgewandelt, auf Qualität und Lizenz geprüft und veröffentlicht. Von rund 554.000 gesammelten Datensätzen wurden rund 32.000 veröffentlicht.
Darf ich die Daten im GOAT-Katalog kostenlos nutzen?
Der Katalog veröffentlicht nur Datensätze mit einer nutzbaren offenen Lizenz. Datensätze, deren Lizenz keine Weitergabe erlaubt, werden ausgelassen. Jeder Datensatz zeigt seine Lizenz in den Metadaten, so dass Sie die genauen Bedingungen vor der Nutzung prüfen können.
Kann ich den GOAT-Katalog in QGIS nutzen?
Ja. Der Katalog folgt dem STAC-Standard (SpatioTemporal Asset Catalog). Sie können ihn also auch aus STAC-Clients wie QGIS oder pystac-client durchsuchen, nicht nur über die Oberfläche von GOAT.
Können KI-Assistenten den GOAT-Katalog durchsuchen?
Ja. Der Katalog hat einen eigenen MCP-Server. Jeder KI-Assistent, der das Model Context Protocol unterstützt, kann ihn in natürlicher Sprache durchsuchen, mit derselben Suche und denselben aufbereiteten Daten wie die Oberfläche von GOAT.
Wozu ein Datenkatalog, wenn eine KI nach Daten suchen kann?
Eine KI-Suche kann zeigen, wo Daten liegen könnten, aber nicht garantieren, dass der Link funktioniert oder der Datensatz der richtige ist. Der Katalog enthält die Daten selbst, schon ausgewählt, umgewandelt und dokumentiert, und damit bereit für die Analyse.